是什么
-
定义:TLB 与 Cache 结构辨识 是通过 408 统考中给出的硬件结构图、地址切分方式或文字参数,快速反推 TLB/Cache 的映射方式、硬件介质(SRAM/DRAM)以及控制策略(替换算法/写策略)的方法。
-
大白话:看懂考卷上的硬件原理图和参数表,一眼看穿“这是什么映射方式”、“用什么芯片造的”、“怎么替换”以及“数据怎么写回”。
核心内容
1. 如何一眼看出 TLB 的映射方式?
看图或看参数时,抓住 “虚页号是否被切分” 和 “比较器的连接方式”:
                    ┌──► 虚页号完整送入每一项比对 ──────────────► 【全相联映射】
                    │
虚页号 (VPN) ───────┼──► 拆为 [ TLB Tag ] + [ TLB 组号 ] ────────► 【K 路组相联映射】
                    │
                    └──► 拆为 [ TLB Tag ] + [ TLB 行号 ] ────────► 【直接映射】
| 判别特征 | 全相联映射(统考最常考) | K 路组相联映射 | 直接映射(极少见) |
|---|---|---|---|
| 看结构图中的比较器 | 每一行都有一个比较器,虚页号同时送入所有比较器并行比对。 | 只有 K 个比较器,先用组号选中一组,组内 K 行并行比对。 | 只有 1 个比较器,先用行号选中一行,直接比对 Tag。 |
| 看地址切分 | 虚页号没有切分,完整的虚页号直接作为 TLB Tag(字段 B 长度 = 虚页号长度)。 | 虚页号被切为 [ TLB Tag ] + [ TLB 组号 ] 两截。 | 虚页号被切为 [ TLB Tag ] + [ TLB 行号 ] 两截。 |
| 文字描述关键词 | “相联存储器(CAM)实现”、“可放入任意表项”。 | “4 路组相联 TLB”、“共 8 项划分为 2 组”。 | “虚页号低位直接作为快表索引”。 |
2. TLB 是用 SRAM 还是 DRAM 实现?
-
标准答案:SRAM(静态随机存储器)。
-
判别理由与考点:
-
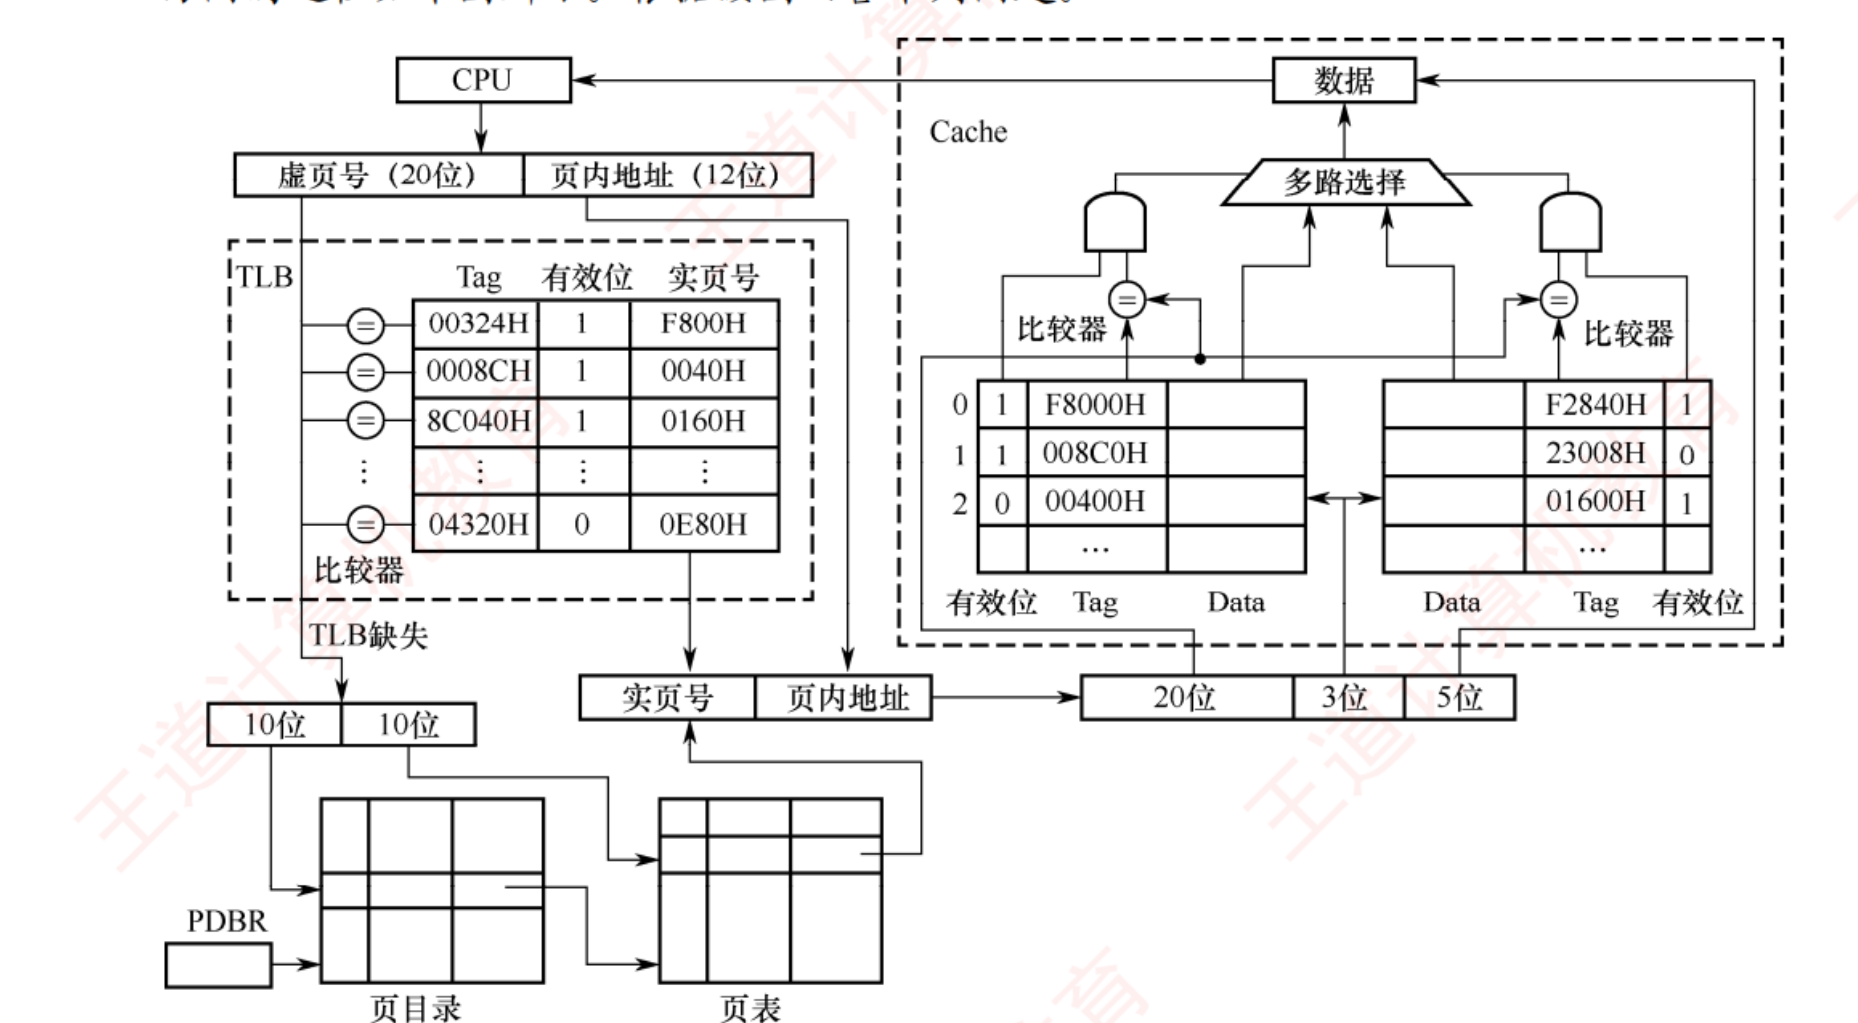
位置与速度需求:TLB(Translation Lookaside Buffer)集成在 CPU 内部(MMU 中),属于极高速缓存,必须在 单个 CPU 时钟周期内 完成虚实地址转换。TLB 与 Cache 都在带有虚线边框的区域内即为CPU内部
-
介质特性:SRAM 采用双稳态触发器存储,速度极快(纳秒级),不需要动态刷新;而 DRAM(动态随机存储器)需要定期刷新且速度较慢,主要用于主存。
-
-
遇到问 “TLB / Cache 采用什么存储介质”:统一回答 SRAM(因为它们都在 CPU 片内,追求极速,不需要动态刷新)。
-
遇到问 “主存(内存)/ 页表存放介质”:统一回答 DRAM(主存容量大、成本低、需要动态刷新)。
3. 如何一眼看出 Cache 的映射方式?
观察 Cache 结构图的 “槽位排列” 与 “物理地址字段切分”:
| Cache 映射方式 | 看结构图特征 | 看物理地址切分特征 |
|---|---|---|
| 直接映射 | 每一行只有 1 个 Data 槽位 和 1 个 Tag 槽位;由“行号”直接索引到具体行。 | 物理地址划分为:[ Tag ] + [ Cache 行号 ] + [ 块内地址 ] |
| K 路组相联映射 | 同一个组号/行号下横向并排了 K 个数据槽位(如左路+右路=2路),对应并联了 K 个比较器。 | 物理地址划分为:[ Tag ] + [ Cache 组号 ] + [ 块内地址 ] |
| 全相联映射 | 无任何行号/组号译码器,物理地址 Tag 直接送入所有 Cache 行的比较器。 | 物理地址划分为:[ Tag ] + [ 块内地址 ](无任何组号/行号) |
4. 替换算法(LRU)与写策略(回写/直写)的判定与标志位
① 替换算法判断(LRU vs 其他)
-
判定规则:
-
直接映射:位置唯一确定,不需要任何替换位(0 bit)。
-
组相联 / 全相联映射:若题目明确采用 LRU 算法,单行所需的替换控制位为:
-
2 路组相联:
-
4 路组相联:
-
8 路组相联:
-
-
② 写策略判断(回写法 vs 直写法)
-
回写法(Write Back / 写回法):
-
核心特征:只写 Cache 不立即写主存,仅在 Cache 行被替换淘汰时才写回主存。
-
必备标志位:必须包含 1 位“脏位/修改位(Dirty Bit)”(1 表示被修改过,0 表示未修改)。
-
-
直写法(Write Through / 全写法):
-
核心特征:写 Cache 的同时写回主存(通常配有 Write Buffer)。
-
必备标志位:不需要脏位(0 bit),因为 Cache 与主存数据时刻保持一致。
-
5. 单行控制位综合速查清单
看主存物理地址占多少位
一、方法一:Cache 视角切分(向下看)
根据 Cache 的三种映射方式,物理地址切分公式通用覆盖如下:
-
组相联映射(考得最多):
-
直接映射:
-
全相联映射:
任何一个物理地址送入 Cache,其二进制位都必须且只能被瓜分为这几个字段,因此各字段位数之和必定严格等于物理地址总位数。
二、方法二:虚存分页视角拼接(向上看)
在页式/段页式虚拟存储管理中:
-
为什么绝对通用:
-
分页机制的核心原理就是“把物理内存按固定页面切块”。
-
物理地址的高位用来定位是第几个物理页面(实页号),低位用来定位页面内部的偏移量(页内地址)。
-
无论是单级页表、多级页表,还是 TLB 快表,虚实地址翻译最终拼出来的物理地址结构永远是
[ 实页号 ] + [ 页内地址 ]。
-
三、考场上唯一的特殊陷阱(非对齐/分段)
这两种方法在以下极特殊场景下看图时需要注意提取方式:
-
纯分段存储管理(非分页):
-
若题目是纯段式虚存,物理地址 (通过加法器计算得出,而不是直接做二进制拼接)。不过 408 绝大多数涉及 Cache/TLB 的大题全部是页式或段页式。
-
-
图里没标实页号位数,只给十六进制内容:
- 例如图中 TLB 表项实页号写着
F800H(4 个十六进制字符 ),此时要确认高位是否有省略前导 0,一般优先以 Cache 的字段切分和给定的主存容量(如 )进行双向验算闭环。
- 例如图中 TLB 表项实页号写着
例题
-
题目(2018 统考真题节选):
某计算机 CPU 进行存储访问的过程示意图中:
-
虚拟地址 32 位(虚页号 20 位,页内地址 12 位),TLB 中每一行左侧均配有一个独立的比较器,直接接收 20 位虚页号;
-
物理地址划分为:
[ 20位 Tag ] + [ 3位 组号 ] + [ 5位 块内地址 ];Cache 结构图中每一行有 2 个并排的 Tag+Data 槽位,并各接一个比较器。
-
请回答:
① TLB 采用什么映射方式?TLB 是用 SRAM 还是 DRAM 实现?
② Cache 采用什么映射方式?若 Cache 采用 LRU 算法和回写法,则 Cache 每一行中除数据、标记和有效位外,还应有哪些附加位?各占几位?
-
-
分析:
-
TLB 判定:20 位虚页号没有切分出组号,直接并行接入所有行的比较器 全相联映射。TLB 位于 CPU 内部要求单周期完成,采用 SRAM。
-
Cache 判定:物理地址给出了“3位组号”,且图中一个组内并排包含 2 个路(2 个槽位、2 个比较器) 2 路组相联映射。(看 Cache 结构图:每一行包含两个槽位(左边一列 Tag+Data,右边一列 Data+Tag),由“3位组号”选中一行,然后每路各有一个比较器并行比对。这说明每组有 2 行,采用的是 2 路组相联映射。)
-
控制位判定:
-
回写法(Write Back) 需要 1 位脏位(修改位);
-
2 路组相联采用 LRU 需要 。
-
-
-
规范答案:
-
TLB 采用 全相联映射;TLB 采用 SRAM 实现。
-
Cache 采用 2 路组相联映射;Cache 每一行除数据、标记和有效位外,还应有 脏位(修改位,1 位) 和 LRU 替换位(1 位)。
-
⚠️ 易错点
Warning
把 TLB 介质错答为 DRAM:DRAM 速度慢且需要周期性动态刷新,只能做主存;TLB 位于 CPU 内部,是与寄存器、Cache 同级别的超高速硬件,必为 SRAM。
全相联 TLB 误切组号:看到 TLB 时,先看虚页号有没有被拆分成两截。若虚页号完整送入比对,则是全相联;千万不要盲目拿主存/Cache 的组数公式套用到 TLB 上。
直写法硬加脏位:直写法(Write Through)数据随时同步写入主存,Cache 行永远与主存一致,绝不需要脏位(Dirty Bit 为 0 位)。
LRU 位数算错基数:组相联映射的 LRU 位数取决于组内路数 (即组相联度),即 ,而不是 Cache 的总行数或总组数。