是什么
-
定义:将一条指令的执行过程分解为若干个独立的执行子过程(流水段),每个子过程由专门的功能部件并行处理,使多条指令在时间上重叠执行的技术。
-
大白话:就像工厂流水线,做衣服分“裁剪、缝纫、熨烫、包装”。不需要等一整件衣服彻底包装完才裁下一件,而是每个工人各司其职,每个时钟周期流出一件成品。
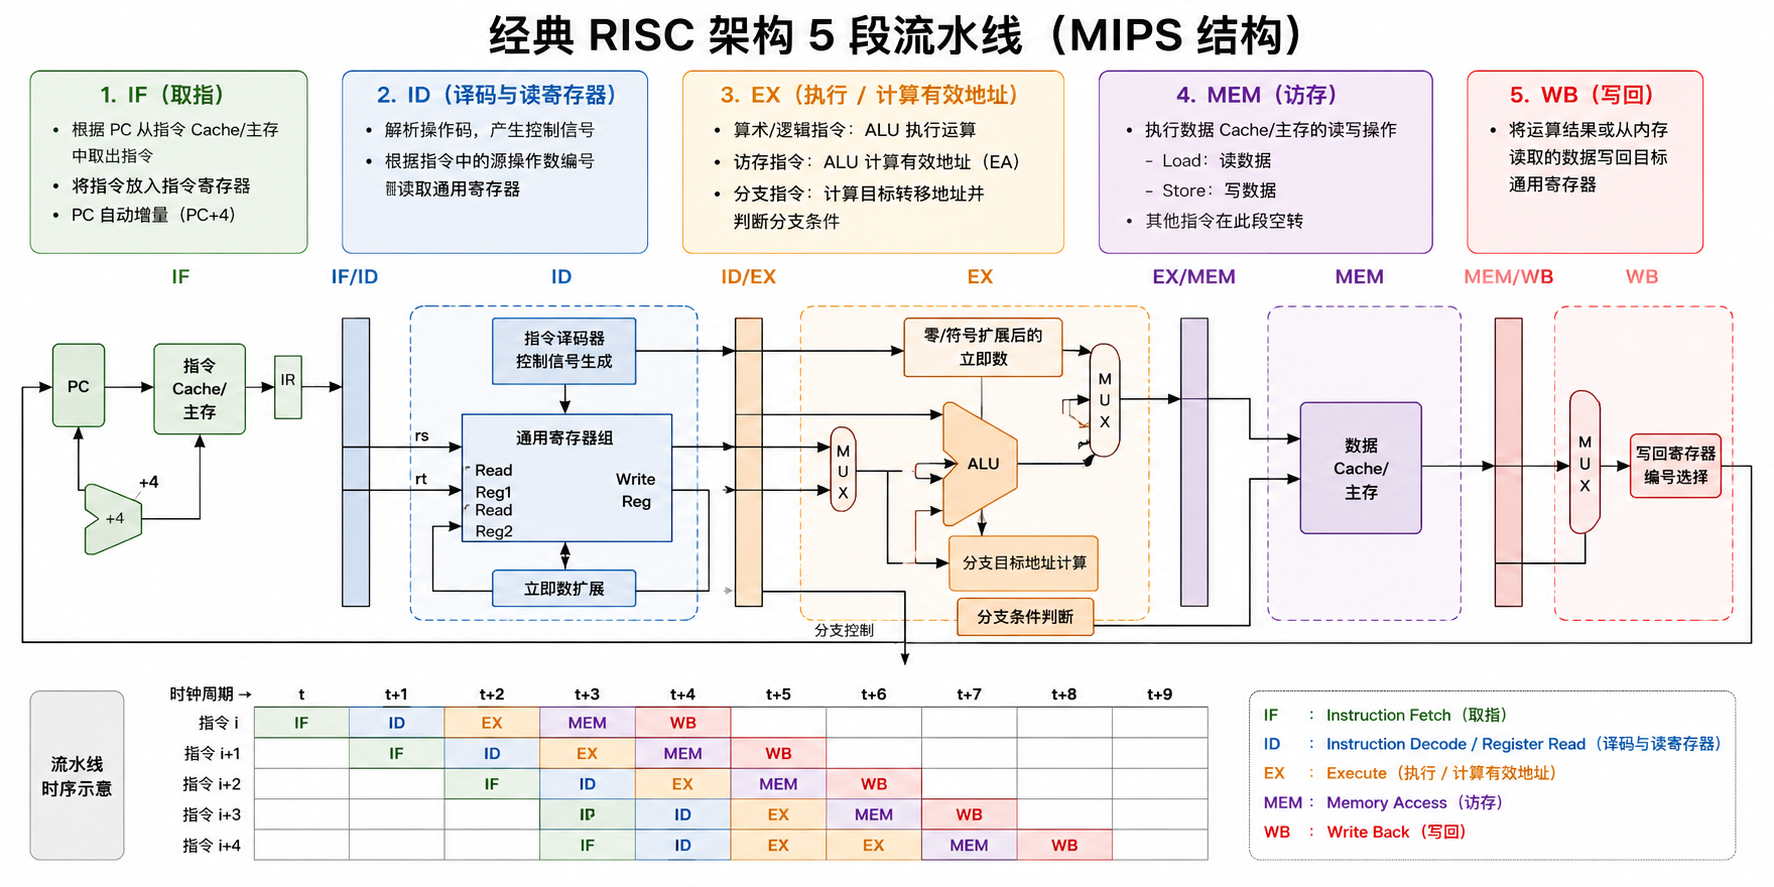
核心内容
1. 经典五段流水线结构
经典 RISC 架构 5 段流水线(MIPS 结构)各段职能:
-
IF(Instruction Fetch,取指):根据 PC 从指令 Cache/主存中取出指令,放入指令寄存器,PC 自动增量。
-
ID(Instruction Decode / Register Read,译码与读寄存器):解析操作码,由硬件产生控制信号,同时根据指令中的源操作数编号读取通用寄存器。
-
EX(Execute,执行/计算有效地址):
-
算术/逻辑指令:ALU 执行运算。
-
访存指令(Load/Store):ALU 计算访存的有效地址(EA)。
-
分支指令:计算目标转移地址并判断分支条件。
-
-
MEM / M(Memory Access,访存):执行数据 Cache/主存的读写操作(Load 读数据,Store 写数据)。其他不需要访存的指令在此段空转。
-
WB(Write Back,写回):将运算结果或从内存读取的数据写回目标通用寄存器。
注:如果发生相邻指令发生写后读(RAW),则后一条指令必须等前一条指令WB结束(即WB的下一拍)才能执行ID(读取)。即至少等3拍。
2. 流水线性能与周期计算
设流水线段数为 ,每段耗时为 ,需执行 条指令:
-
流水线时钟周期:取决于最慢的那个流水段。
( 为段间流水寄存器的锁存延迟)
-
无阻塞时钟周期数:
(第 1 条指令需 拍,后续每拍流出 1 条指令)
-
有阻塞时钟周期数:
-
加速比(Speedup)与吞吐率(TP):
-
加速比:
-
吞吐率:
-
3. 流水线三大冲突(Hazards)与阻塞成因
| 冲突类型 | 本质成因 | 经典场景 | 硬件/软件解决策略 |
|---|---|---|---|
| 结构相关 (Resource Hazard) | 多条指令在同一时钟周期争用同一硬件资源 | 1. 单端口主存同时被 IF 段取指和 MEM 段访存访问 2. 寄存器堆不支持同一周期同时读和写 | 1. 指令 Cache 与数据 Cache 分离(哈佛结构) 2. 寄存器堆采用“前半周期写、后半周期读”双端口机制 3. 插入气泡(NOP 停顿) |
| 数据相关 (Data Hazard) | 后续指令用到的数据依赖于前面指令的执行结果 | 见下文 RAW / WAR / WAW 详解 | 1. 硬件转发(Forwarding / Bypassing) 2. 硬件阻塞(Stall / Bubble) 3. 编译器指令调度(指令重排) |
| 控制相关 (Control Hazard) | 分支/跳转指令在 EX 段前无法确定下一条 PC 的走向 | BEQ、BNE、JMP、中断/异常触发 | 1. 静态/动态分支预测(Branch Prediction) 2. 延迟槽技术(Branch Delay Slot) 3. 预测失败时清空流水线(Flush) |
-
在概念判定题中:只要看到条件转移指令(如
bne、beq) 或 无条件转移指令(jmp、jal),都可以直接认定其会引发控制冒险(因为指令改变了程序的控制流)。 -
在计算题/时空图题中:需要仔细看题设条件——是“直接阻塞 个周期”,还是“采用动态预测且预测成功/失败”,来决定具体扣除几个周期的惩罚。
4. 数据相关深度拆解与旁路转发技术
按读写顺序分为三种(流水线核心必考):
-
RAW(Read After Write,写后读):真相关(True Dependency)。后条指令要读(ID 段),前条指令还没写回(WB 段)。最常见、必考!
-
WAR(Write After Read,读后写):反相关(Anti-dependency)。后指令写覆盖了前指令本该读的旧值(仅在乱序执行、超标量流水线出现)。
-
WAW(Write After Write,写后写):输出相关(Output Dependency)。后指令比前指令先写回,导致寄存器保留了过时的旧值(仅在多发射/乱序流水线出现)。
未采用转发技术 vs 采用转发技术(Forwarding):
-
无转发技术:数据必须走到 WB 段结束 写入通用寄存器,后续指令才能在 ID 段 读出。若第 条指令是 ALU 运算,其结果在 EX 段就算出来了,但必须等它经过 MEM 和 WB 后, 才能读,流水线被迫停顿 2 拍;若是 Load 指令,需等其 MEM、WB 走完,停顿 3 拍。
-
有转发技术(旁路通路):直接把 EX 段或 MEM 段的计算结果用专用数据线拉回 EX 段的输入端。
-
ALU 类指令: 在 EX 段算完后,直接转发给 的 EX 输入端,停顿 0 拍。
-
Load-Use 数据冒险:(Load)的数据必须在 MEM 段访存结束才出来,即便采用转发,也无法直接在 EX 段供给 的 EX 输入,仍必须强制停顿 1 拍(Load-Use Delay)。
-
-
相邻的 ALU 类 RAW 冲突(前一条算完写,后一条紧跟着读):必须停 3 拍。
-
相邻的 LOAD-USE 冲突(前一条访存读入,后一条紧跟着读):同样停 3 拍。
5. 指令优化与代码重排(Instruction Scheduling)
-
核心思想:通过编译器重新排列指令顺序,在保持原程序逻辑和数据依赖关系不变的前提下,将不相关的独立指令填入数据冒险的等待空泡(Delay Slots)中。
-
优化原则:
-
将 Load 后的独立指令提升到 Load 之后、依赖它的指令之前执行。
-
遇到多个独立的加载/计算任务(如多变量加载),采用交错加载(Interleaving)模式掩盖访存延迟。
-
例题
-
题目:某 5 段流水线(IF, ID, EX, M, WB)未采用转发技术,同一寄存器读写不可在同一周期进行。执行以下代码片段:
I1: LOAD R1, [a] ; 从内存 a 读入 R1 I2: ADD R1, R2 ; R1 + R2 -> R2 I3: STORE R2, [b] ; 将 R2 存入内存 b-
分析 对 、 对 产生的数据相关类型。
-
若该机器采用“按序发射”,画出未优化时的流水线时空图,并说明如何通过指令调度优化周期数。
-
-
分析:
-
写入 R1,而 需要读取 R1,构成 RAW(写后读)数据相关;同理 写入 R2, 读取 R2,构成 RAW 数据相关。
-
无转发且读写不同拍: 在第 5 拍(WB)写回 R1, 的 ID 段最早只能在第 6 拍执行; 在第 9 拍(WB)写回 R2, 的 ID 段最早在第 10 拍执行。
-
-
答案:
-
与 存在基于 R1 的 RAW(写后读/真相关); 与 存在基于 R2 的 RAW(写后读/真相关)。
-
未优化时空图(总计 13 个时钟周期):
-
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| (LOAD) | IF | ID | EX | M | WB | ||||||||
| (ADD) | IF | ID | EX | M | WB | ||||||||
| (STORE) | IF | ID | EX | M | WB |
优化策略:在 和 之间插入与 R1 无关的其他操作(如加载其他变量 ),填补 访存和写回期间的 3 拍停顿;若无其他代码可插入,则只能由硬件硬件暂停(Stall)。
⚠️ 易错点
Warning
寄存器“前半拍写、后半拍读” vs “读写不可同拍”:
若题目说明“支持前半拍写、后半拍读”: 在第 5 拍 WB 段写入,则 在第 5 拍即可完成 ID 段读数。
若题目说明“读写不能在同一周期进行”: 在第 5 拍写回, 的 ID 段必须推迟到第 6 拍。
转发技术消除气泡的极限(Load-Use 陷阱):
转发技术不能消除所有 RAW 停顿!对于
LOAD紧跟ALU指令的场景,由于数据在 MEM 段末尾才从内存读出,即使有旁路硬件,也必须暂停 1 个时钟周期。按序发射导致的级联阻塞:
- 当 在 ID 段发生阻塞时,由于按序发射限制,后续的 无法进入 ID 段,其 IF 段也会被卡住停顿在流水线前端,不要误画成后续指令继续向前发射。
(R2) << 2 → R4:
CPU 在执行这条指令时,硬件只是读取(Read)了寄存器 R2 里的值,将其送入移位器进行左移 2 位计算,然后把计算得到的新结果写入(Write)到了寄存器 R4 中。
核心原则:汇编指令在“读”源寄存器时,是非破坏性读取(相当于复制一份数据去计算),只有作为目的寄存器被写入时,原有的值才会被覆盖。因此
R2自身的值完全没有改变。