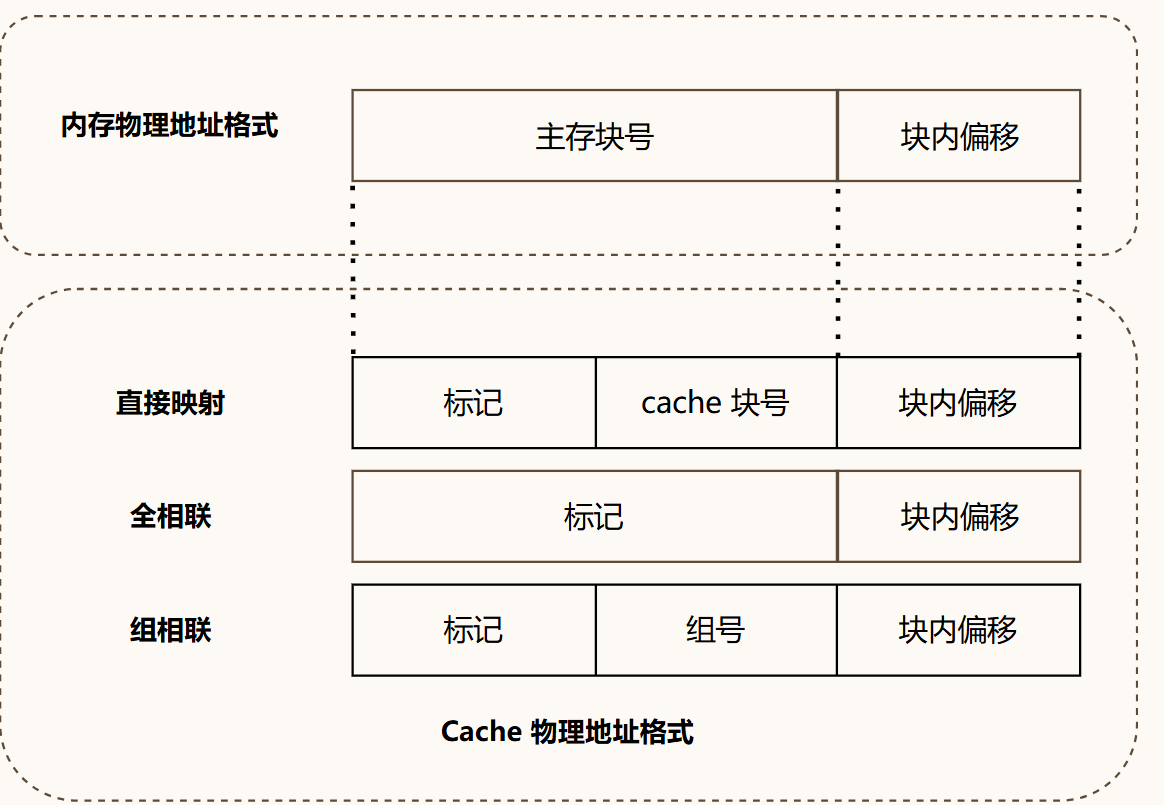
一、物理地址的硬件判定逻辑划分
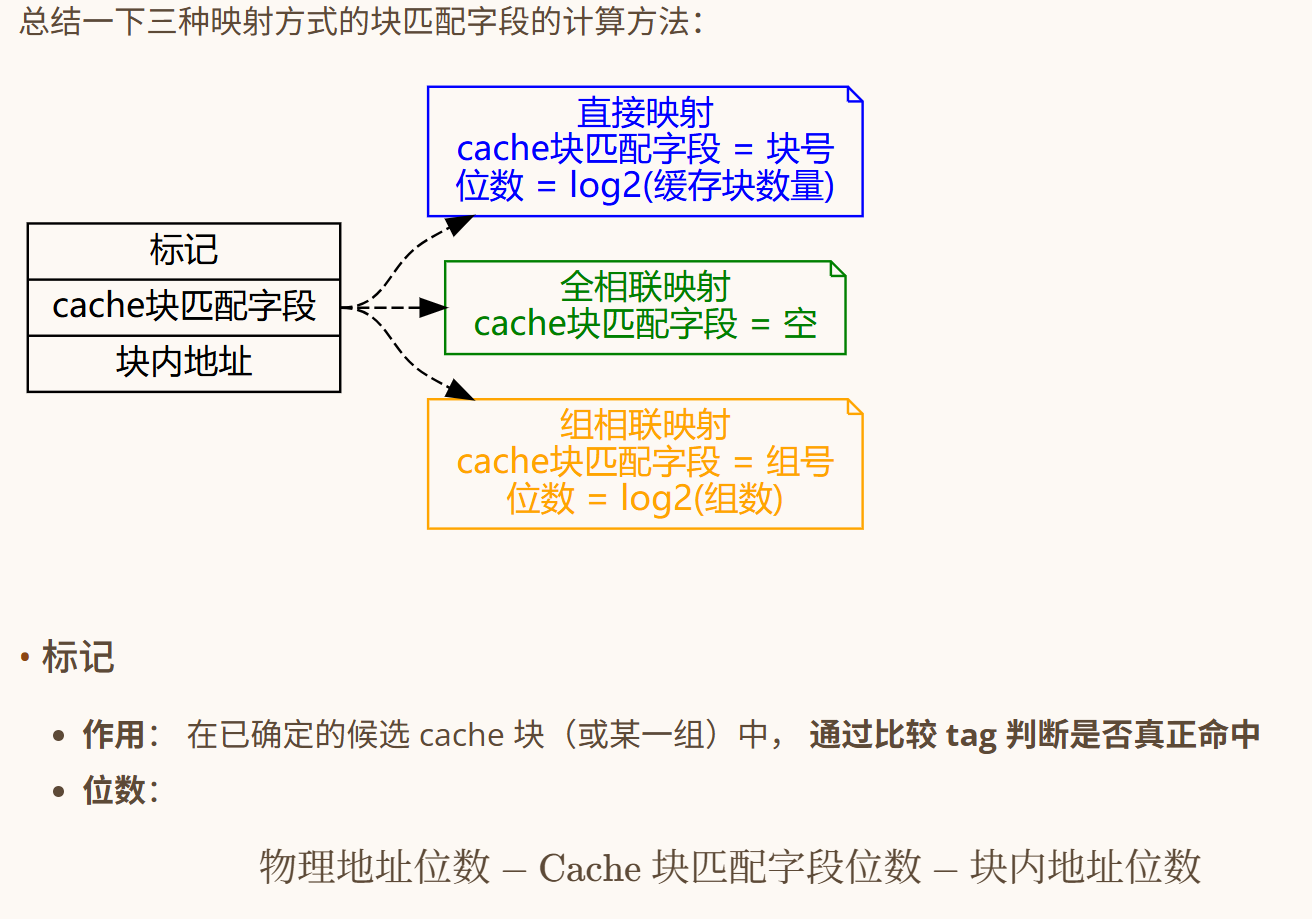
从硬件判定流程的角度,物理地址在逻辑上划分为以下三部分:
| 标记 (Tag) | 块匹配字段 (Index / Slot) | 块内地址 (Offset) |
|---|
-
块内地址 (Offset)
-
作用:确定访问数据在一个主存块 / Cache 块内的具体字节偏移。
-
位数:。
-
说明:这一部分只用于块内寻址,与映射方式完全无关。
-
-
Cache 块匹配字段 (Index / Slot)
-
作用:用于缩小搜索范围,硬件依据该字段直接定位到特定的 Cache 块或组。
-
含义:因映射方式而异(全相联无此字段、直接映射为块号、组相联为组号)。
-
-
标记 (Tag)
-
作用:唯一标识映射到该位置的主存块身份。当定位到对应 Cache 行后,硬件比较器通过比对 Tag 与有效位判断是否命中。
-
位数:。
-
二、性能与访问时间核心计算公式
1. Cache 缺失率 (Miss Rate)
-
公式参数备注:
-
:程序执行过程中访问目标数据时发生的 Cache 缺失总次数(即需要从主存调入新块的次数)。
-
:程序执行期间对该目标数据的总访存次数(读写分别各计一次)。
-
2. 数组元素的平均访问时间 (AMAT, Average Memory Access Time)
-
公式参数备注:
-
:CPU 访问该数组元素的平均耗时(单位:时钟周期或纳秒)。
-
:Cache 命中的访问时间(如命中需 2 个时钟周期)。
-
:上述计算所得的数据访问 Cache 缺失率。
-
:缺失损失(Miss Penalty),即从缺失触发到完成块调入所需的惩罚时钟周期(如 200 个时钟周期)。
-
三、真题原卷情境还原与基础参数
题目背景: 计算机 M 字长 32 位,按字节编址。数据 Cache 的数据区大小为 32KB,主存块大小为 64B,Cache 命中时间为 2 个时钟周期,缺失损失为 200 个时钟周期,页大小为 4KB。 数组
int d[2048];起始地址为0180 0020H(未对齐)或0180 0000H(对齐)。 循环操作代码:C
int x, d[2048], i;
for (i = 0; i < 2048; i++)
    d[i] = d[i] / x;
设代码已在 Cache 中, 已装入内存但不在 Cache。
全场景通用参数:
-
块内地址位数: 位(低 6 位:)。
-
Cache 总块数(行数): 行。
-
每个
int占 4 字节,每个 64B 主存块整块最多容纳 个元素。 -
循环总访存次数:每次迭代包含 1 次读 和 1 次写 ,总访存 次。
四、三大映射方式深度剖析与题目真枪实战
1. 组相联映射 (Set-Associative Mapped) ——【真题原卷配置:8路组相联】
映射原理与硬件结构
-
主存块映射到固定组,但可存入组内 行中的任意一行。
-
参数备注: 为主存块号; 为总组数; 为每组路数(相联度)。
-
原卷参数: 路,Cache 组数 组(组号占 位)。
-
地址切分:
Tag(20 位) +组号 (Index)(6 位) +块内地址 (Offset)(6 位)。 -
硬件匹配机制:
-
地址中的 Tag 同时送入 8 个比较器,分别与组内 8 个块的 Tag 进行并行比对,并结合 Valid 位判定是否命中。
-
比较器 (Comparator):用于判断 Cache 块中的 Tag 是否与当前访问地址的 Tag 匹配且有效,决定是否命中。
-
选择器 (Multiplexer):在多个块有可能命中的情况下,负责根据比较结果从 8 路中选出正确的数据通路输出给处理器;若都未命中,则发起主存访问。
-
题目实战计算:未对齐 vs 对齐
🔴 模式 1:首块未对齐(原卷条件:起始地址 0180 0020H)
-
首块占用:起始地址低 6 位为 的低 6 位 。 从块的第 32 字节开始存放,首块只能容纳 个元素()。
-
块跨越总数:剩余 个元素,整块容纳 16 个。
-
缺失次数:单流顺序访问,每个新块在首次读时发生 1 次读缺失,其后同块内的读与写全命中。总缺失 次。
-
缺失率与平均访问时间:
🟢 模式 2:首块已对齐(变式条件:起始地址 0180 0000H)
-
首块占用:起始地址低 6 位为 0,首块容纳完整的 16 个元素()。
-
块跨越总数:
-
缺失次数:总缺失 次。
-
缺失率与平均访问时间:
2. 直接映射 (Direct Mapped) ——【变式 1】
映射原理与硬件结构
-
每个主存块只能严格映射到 Cache 中的一个固定块。
-
参数备注: 为主存块号; 为 Cache 总块数(512 块)。
-
地址切分:
Tag(17 位) +Cache 块号 (Index)(9 位,因为 ) +块内地址 (Offset)(6 位)。 -
硬件匹配机制:
-
比较器 (Comparator):仅需 1 个比较器。硬件用 9 位块号直接寻址到唯一的 Cache 行,将行内 Tag 与地址 Tag 比对。
-
选择器 (Multiplexer):无需选择器,因为每个索引对应唯一的行。
-
题目实战计算:未对齐 vs 对齐
🔴 模式 1:首块未对齐(起始地址 0180 0020H)
-
占用块数:同样跨越 129 个连续主存块。
-
冲突判断:Cache 共有 512 块,数组仅连续占用了 129 个主存块(),主存块号模 512 映射到 Cache 中互不冲突!单次顺序扫描完全不会发生冲突踢出。
-
缺失与时间计算:
-
总缺失 次。
-
。
-
。
-
🟢 模式 2:首块已对齐(起始地址 0180 0000H)
-
占用块数:128 个连续主存块。
-
缺失与时间计算:
-
总缺失 次。
-
。
-
。
-
3. 全相联映射 (Fully-Associative Mapped) ——【变式 2】
映射原理与硬件结构
-
主存中的每一个块可以存放在 Cache 的任意一个空闲块位置中。
-
地址切分:
Tag(26 位,主存块号全部作为 Tag) +块内地址 (Offset)(6 位),无任何匹配字段。 -
硬件匹配机制:
-
比较器 (Comparator):需要 512 个比较器。硬件把地址中的 Tag 与 Cache 内全部 512 个块的 Tag 同时并行比对。
-
选择器 (Multiplexer):512 选 1 的多路选择器,根据命中行选出数据通路送往 CPU。
-
题目实战计算:未对齐 vs 对齐
🔴 模式 1:首块未对齐(起始地址 0180 0020H)
-
占用块数:129 块。
-
容量判断:Cache 总容量为 512 块,129 块能轻松完整放入 Cache 的任意空闲行,无任何冲突与容量淘汰。
-
缺失与时间计算:
-
总缺失 次。
-
。
-
。
-
🟢 模式 2:首块已对齐(起始地址 0180 0000H)
-
占用块数:128 块。
-
缺失与时间计算:
-
总缺失 次。
-
。
-
。
-
五、底层机理精讲:时序追踪与容量判定
1. 为什么“写”不增加缺失?为什么不是 次缺失?
针对循环内语句 d[i] = d[i] / x;: CPU 指令执行在底层具有严格的时序先后顺序:
-
读操作 (
Load):-
CPU 发出读请求,访问 。
-
若 为一个新主存块的首个访问元素(如 ),由于未进缓存,触发 Cache 读缺失 (Read Miss)。
-
硬件启动缺失响应:把 所在的整整一个 64B 主存块一次性从内存搬入 Cache 的对应行。
-
读操作完成,元素送入 CPU 寄存器。
-
-
算术运算 (
ALU):-
CPU 在寄存器内部完成除法运算(
d[i] / x),完全不发生外部访存。
-
-
写操作 (
Store):-
CPU 将除法结果写回 的主存地址。
-
核心关键:刚刚第 1 步才把该块完整调入 Cache,此时该块百分之百已经在 Cache 中!
-
因此写操作必然为 Cache 命中 (Write Hit),直接写入 Cache 对应行,绝不可能再次发生缺失。
-
-
同块后续元素:该块内的其余元素,读时命中,写时命中。
结论:每个主存块只有在第一次被读取时发生 1 次缺失;随后的所有读与写操作全部命中。总缺失次数严格等于跨越的主存块数(129 次),绝不会翻倍为 。
2. 为什么能断定“组数为 64,容量远够容纳局部工作集”?
做题时断定“刚调进来的块在循环过程中绝对不会被中途置换出 Cache”,依托于以下两个硬件事实:
-
局部工作集 (Working Set) 极小:
-
每次循环迭代中,CPU 活跃访问的数据极其有限:
-
当前正在处理的数组元素块 (1 个块)。
-
变量 (仅 1 个块,首轮载入后驻留)。
-
循环变量 与程序代码指令(题目明确已在 Cache 中)。
-
-
在任何极短时间片内,系统同时活跃的数据块仅有 1 ~ 2 个。
-
-
相联度提供充足槽位:
-
Cache 为 8 路组相联,表示同一个组最多可以同时接纳 8 个映射相同的主存块。
-
即使发生最极端的冲突哈希碰撞——变量 刚好映射到与当前数组块 完全相同的组,该组也仅仅占用了 2 个行槽位,距离 8 路填满并触发替换算法(如 LRU)淘汰旧块还差得很远。
-
连续单流扫描时,数组块在当前组内的所有元素读写完成之前,绝不会被意外驱逐。
-
六、进阶拓展:除法器数据通路与硬件异常响应
1. 补码除法器数据通路寄存器配置模型
在定点补码除法器(加减交替法/不恢复余数法)中,双字长运算由 {R, Q} 联合寄存器配合完成:
| 寄存器 | 位宽 | 角色功能 | 初始化装载内容 |
|---|---|---|---|
| 余数寄存器 | 32 位 | 存放被除数高位 / 迭代余数 | 64 位被除数的高 32 位(由 32 位数经符号扩展 SEXT 产生的符号拓展位) |
| 商寄存器 | 32 位 | 存放被除数低位 / 移位接收商 | 64 位被除数的低 32 位(即原 32 位被除数本身) |
| 除数寄存器 | 32 位 | 存放除数 | 32 位除数本身 |
| 控制逻辑 / 计数器 | - | 控制移位次数与节拍生成 | 计数除法步数(32 位除法计数 32 次) |
-
ALU 运算类型:加减交替除法中,ALUop 只需控制 加法 和 减法 2 种运算。每一步根据余数与除数的符号同号或异号,决定加除数还是减除数。
⚠️ 命题避坑细节:
位宽补全:写 32 位寄存器初始值时,必须写满 8 位十六进制数(例如 必须规范写成
0x000000FF)。寄存器位置对应:硬件结构图左侧 对应高 32 位,右侧 对应低 32 位。符号扩展负数时,
R = 0xFFFFFFFF,Q = 0x87654321,严防高低位填反。
2. 有符号除法(idiv)异常触发双陷阱
408 考查除法指令 idiv(64位被除数 32位除数 32位商)时,异常不仅限于除以零,存在两大必背触发条件:
陷阱 1:除以零(Divide-by-zero)
-
现象:除数寄存器 为全 0。
-
机器数特例:
-
除数 :
0x00000000 -
被除数 :任意有效机器数(如
0x87654321)
-
陷阱 2:补码商溢出(Integer Overflow,高频盲点!)
-
现象:商超出了 32 位补码有符号整数的表示范围 (即
0x80000000到0x7FFFFFFF)。 -
唯一极端机器数组合(必背!):
-
被除数 机器数为
0x80000000 -
除数 机器数为
0xFFFFFFFF
-
-
底层原理:
。但 32 位带符号正数最大只能表示到 。理论上的商 在 32 位寄存器中发生溢出,硬件直接触发除法异常(Fault)!
3. CPU 异常响应三部曲(异常隐指令)
当检测到除法异常(属于内部异常/故障 Fault)时,由硬件逻辑(中断/异常隐指令)在进入操作系统内核服务程序前自动完成以下三步:
-
关中断:硬件将中断允许位(如 IF 标志)置 0,屏蔽新的可屏蔽中断。
-
保护断点与程序状态:
-
将当前发生异常的指令地址(PC,故障类异常保存的是当前指令自身地址,便于处理后重新执行)压入内核栈。
-
将当前的程序状态字寄存器(PSW / EFLAGS)压入内核栈。
-
-
引出异常处理程序:根据该异常的向量号(除法错向量号为 0),硬件查询中断向量表(IDT),获取除法错误处理程序的入口地址并写入 PC,CPU 切换至内核态开始执行。