一、用一个生活比喻彻底搞懂
想象你去查一本超级大字典:
-
虚拟地址(虚页号 + 页内偏移):你想查“第 15 篇课文的第 30 个字”。
-
主存(物理内存):实际印刷这本大字典的纸质书。
-
物理地址(物理页框号 + 页内偏移):这本书实际的“第 800 页第 30 个字”。
1. 为什么需要页表?
-
课文不是按顺序印在书里的(为了灵活管理内存碎片)。
-
所以书的前面有一份目录(页表,Page Table),记录着:“第 15 篇课文在书的第 800 页”。
-
问题来了:页表本身也是存放在主存(内存)里的!
-
如果没有 TLB,CPU 每次想读一个数据:
-
第一次访存:去内存里查目录(查页表),得到“第 800 页”;
-
第二次访存:再去内存里的第 800 页读出真正的字。
- 代价:每一次普通的内存访问,硬件都要跑两次内存,速度直接减半!
-
2. TLB 是什么?(救星出场)
-
TLB(Translation Lookaside Buffer,旁路转换缓冲 / 快表):
-
就是 CPU 芯片内部放的一张“便签纸(极速硬件缓存)”!
-
CPU 把最近查过的几条目录记录(虚页号 物理页框号)抄在了这张便签纸上。
-
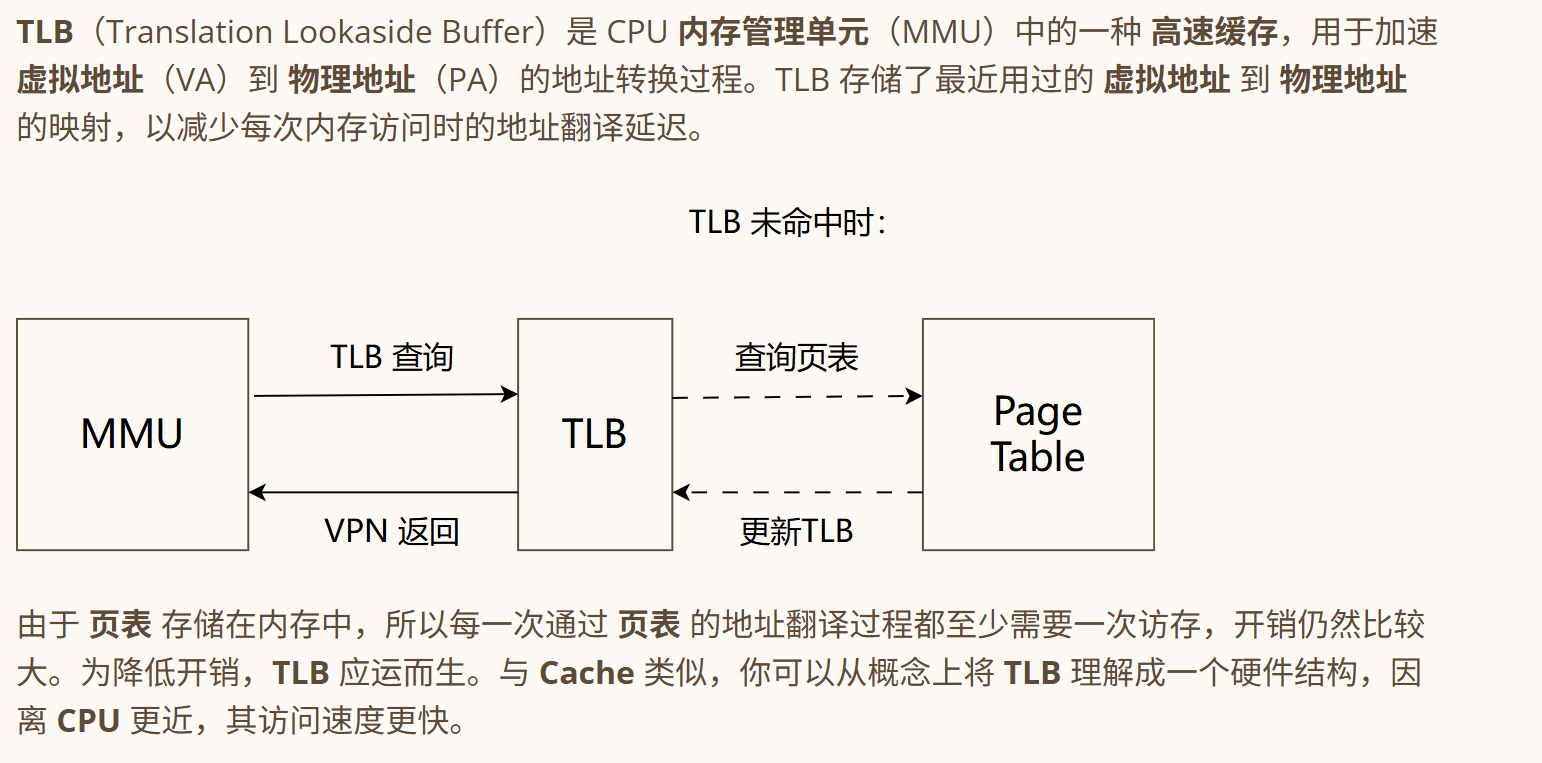
下次再想查第 15 篇课文在哪?先看一眼便签纸(查 TLB,只要零点几个时钟周期):
-
命中(TLB Hit):便签上写着呢!直接拿到“第 800 页”,省去了一次查内存页表的时间!
-
未命中(TLB Miss):便签上没有,认栽,老老实实去内存查页表,查完顺便把这个对应关系写回便签纸(写入 TLB)。
-
-
3. 为什么又来一个 Cache?
-
TLB 缓存的是:【地址翻译规则】(虚页号 物理页框号)。它不存具体的数据或代码!
-
Cache(数据/指令Cache)缓存的是:【真正的数据/指令内容】(比如第 800 页上写的具体文字是啥)。
三、关键点拆解(解开你所有疑惑)
疑问 1:为什么算 TLB 时,根本不用管“页内偏移”?
-
你看上面的流程:不管是虚拟地址还是物理地址,“页内偏移”是完全一模一样的!
-
比如一页是 1KB,不管这一页被放在内存的哪块地方,我要读这一页里的“第 15 个字节”,它在物理页里依然是“第 15 个字节”。
-
TLB 只负责把“虚页号”翻译成“物理页框号”,页内偏移根本不进 TLB 参与查找,所以算 TLB 的标记(Tag)和索引时,第一步先把页内偏移扣掉!
疑问 2:TLB 的“表项”里面到底存了什么?
TLB 就是个小 Cache,它的每一行(表项)里面存的就是:
-
TLB Tag(就是上题算的东西):
-
因为采用了组相联映射,虚页号被拆成了
[ TLB Tag | TLB 组号 ]。 -
CPU 拿虚页号里的“组号”定位到某一组,然后把里面的几个表项的
TLB Tag拿出来和输入的 Tag 比对,看哪个对得上。
-
-
物理页框号:
- 一旦 Tag 对上了,立刻把存着的物理页框号吐出来,和刚才放在一旁的“页内偏移”拼在一起,物理地址就瞬间诞生了!
四、30秒速记核心口诀
“TLB 翻地址,Cache 存数据;”
“偏移原样照抄走,虚页送进 TLB 变物理。”
逐级推导位数
-
计算页内偏移位数(Offset):
-
页面大小为 。
-
按字节编址,所以页内偏移占用 10 位。
-
-
计算虚拟页号(VPN)的位数:
-
虚拟地址共 32 位。
-
。
-
-
计算 TLB 的组数(Set 数)与组索引位数(TLB Index):
-
TLB 共有 32 个表项。
-
采用 4 路组相联映射(每组有 4 个表项/路)。
-
。
-
,因此TLB 组号(组索引)需要 3 位。
-
-
计算 TLB 标记字段(Tag)位数:
-
虚页号(22位)在 TLB 组相联映射下被划分为:[ TLB Tag | TLB 组号 (3位) ]。
-
。
-